이 장에서 배우는 것
/api/ai가 OpenAI 호환이라는 게 실무에서 무슨 뜻인지, 무엇을 바꾸고 무엇을 안 바꿔도 되는지.SDK·파이썬이 무엇인지 모르겠다면 프로그램과 언어를 먼저 보세요.
OpenAI SDK의 base 주소만 바꾸면 내 컴퓨터의 모델이 응답합니다.
코드는 그대로입니다. 라이브러리도 그대로입니다.
나머지는 손대지 않습니다. 스트리밍도, 함수 호출도, 기존 코드 그대로입니다.
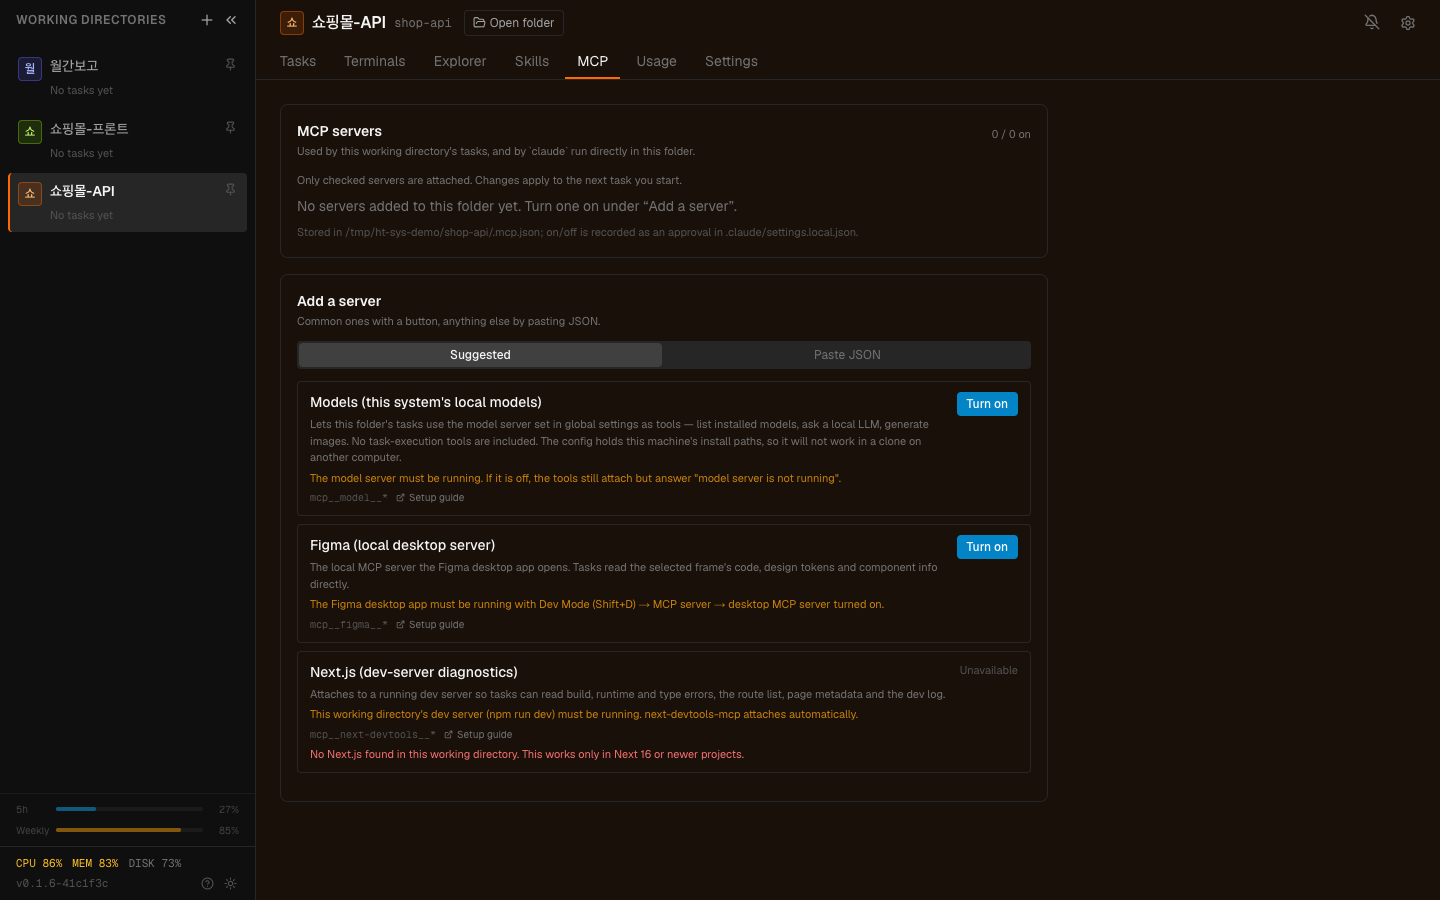
하이퍼팀즈(HyperTeams) 의 ⋯ → 도구 탭, 도구 추가의 MCP 묶음입니다. 이 폴더의 업무에 어떤 도구를 붙일지 여기서 켜고 끕니다.
API 표면에서 inference 모드가 여는 목록입니다.
| 종류 | 경로 |
|---|---|
| 목록 | /v1/models |
| 대화 | /v1/chat/completions |
| 완성 | /v1/completions |
| 임베딩 | /v1/embeddings |
| 검열 | /v1/moderations |
| 음성 → 글 | /v1/audio/transcriptions |
| 글 → 음성 | /v1/audio/speech |
| 오디오 분류 | /v1/audio/classification |
| 이미지 생성 | /v1/images/generations |
| 이미지 편집 | /v1/images/inpainting |
| 이미지 확대 | /v1/images/upscale |
음성과 이미지는 다음 장에서 따로 다룹니다.
graph TD
  A["내 애플리케이션"] --> B["OpenAI SDK"]
  B --> C1["상용 API"]
  B --> C2["내 컴퓨터 · HyperTeams"]
  C1 -.->|"base 주소 한 줄"| C2
개발은 로컬 모델로, 운영은 상용 API로 — 또는 그 반대로. 코드 분기 없이 설정만으로 오갑니다.
고객 정보나 미공개 자료를 다루는 처리를 로컬 모델로 돌립니다. 조심할 것에서 "업무용은 업무용 환경에서"라고 한 것의 가장 강한 형태입니다 — 아예 나가지 않습니다.
임베딩이나 분류처럼 대량으로 반복되는 호출은 로컬로 돌리면 건당 비용이 없습니다. 품질이 충분한 작업이면 차이가 큽니다.
같은 코드로 base 주소만 바꿔가며 모델을 비교할 수 있습니다. 어느 모델이 우리 데이터에 맞는지를 직접 재는 게 가장 확실합니다.
| 작업 | 로컬 적합성 |
|---|---|
| 분류·태깅 | 높음 — 반복 많고 난이도 낮음 |
| 임베딩 | 높음 — 대량 처리 |
| 요약 (짧은 글) | 높음 |
| 음성 인식·합성 | 높음 — 뒤 장 참고 |
| 긴 문서 추론 | 중간 — 모델과 하드웨어에 달림 |
| 복잡한 코드 작성 | 낮음 — 상용 모델이 앞섬 |
모델 라우팅의 로컬판입니다. 난이도에 맞춰 고르되, 여기서는 선택지에 "내 컴퓨터"가 하나 더 생긴 것입니다.
상용 API의 모델 이름을 그대로 쓰면 없습니다. 먼저 목록을 확인하세요.
하드웨어에 따라 훨씬 느릴 수 있습니다. 상용 API 기준으로 잡아둔 타임아웃이 그대로면 실패합니다. 먼저 한 번 재보고 여유를 두세요.
주소를 잘못 넣어 이 대시보드가 자기 자신을 부르면 508로 끊깁니다. 이건
버그가 아니라 무한 루프를 막는 장치입니다 — 안 끊으면 홉마다 소켓이 쌓입니다.
508을 보면 주소가 자기 자신인지 확인하세요.
inference인데 관리 경로를 부릅니다모델을 내려받거나 서버를 재시작하는 호출은 inference에서 404입니다. 필요한
동작이 정말 관리 경로인지 먼저 확인하고, 맞다면 full이 필요합니다 — 다만 그건
그 프로그램에게 내 모델 서버 관리 권한을 주는 것입니다.
| 붙이는 대상 | base |
|---|---|
| OpenAI 호환 SDK·도구 | …/api/ai/v1 |
| 다른 HyperTeams 대시보드 | …/api/ai |
SDK를 쓴다면 앞쪽입니다. SDK가 경로에 /v1을 자동으로 붙이지 않기 때문에
base에 포함시켜야 합니다.
아닙니다. 작업마다 맞는 게 다릅니다. 로컬이 좋은 것(반복·대량·유출 위험)과 상용이 좋은 것(어려운 추론·긴 컨텍스트)을 나눠 쓰는 게 맞습니다. OpenAI 호환이라 둘을 섞어 쓰는 비용이 낮다는 게 장점입니다.
작은 모델로 되는 일부터 하세요 — 분류, 태깅, 임베딩. 이런 건 큰 모델이 필요 없습니다. 어려운 것만 상용으로 넘기면 됩니다.
터널을 열면 됩니다. 다만 그 순간 열쇠 하나로 내 대시보드도 열립니다. 팀 단위로 모델을 공유할 목적이라면 Connect 쪽이 권한 관리에 맞습니다.
1. 기존 코드에서 무엇을 바꿔야 합니까?
base 주소와 열쇠, 두 줄뿐입니다. OpenAI 호환이라 SDK·스트리밍·함수 호출 코드는 그대로 둡니다.
2. 508 응답을 받으면 무엇을 의심해야 합니까?
주소가 자기 자신인지입니다. 대시보드가 스스로를 부르는 루프를 감지해 끊은 것이고, 안 끊으면 홉마다 소켓이 쌓이기 때문에 있는 장치입니다.
3. 로컬 모델이 특히 잘 맞는 작업 유형은?
분류·태깅·임베딩처럼 반복이 많고 난이도가 낮은 것, 그리고 밖으로 나가면 안 되는 데이터입니다. 어려운 추론이나 복잡한 코드 작성은 상용 모델이 앞섭니다.
음성과 이미지는 성격이 달라 따로 봅니다 → 음성과 이미지 다루기
from openai import OpenAIclient = OpenAI( base_url="http://localhost:27777/api/ai/v1", # ← 이 줄 api_key="<대시보드 비밀번호>", # ← 이 줄)r = client.chat.completions.create( model="...", messages=[{"role": "user", "content": "안녕하세요"}],)import OpenAI from "openai";const client = new OpenAI({ baseURL: "http://localhost:27777/api/ai/v1", apiKey: process.env.HT_KEY,});curl -H "Authorization: Bearer $HT_KEY" \ http://localhost:27777/api/ai/v1/models HyperTeams